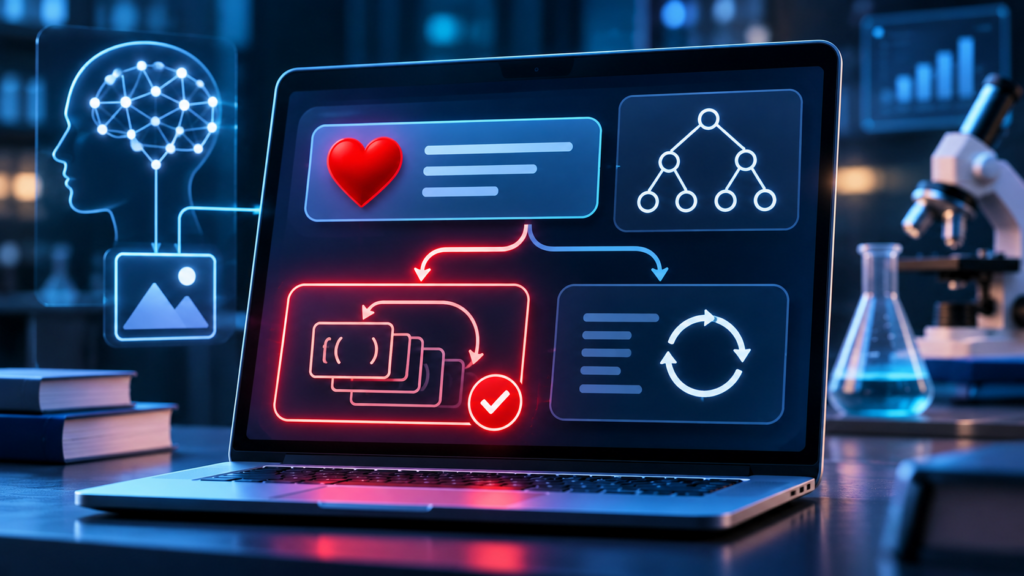
ماذا يحدث لو أرفقت صورة قلب أحمر بسؤال برمجي لا علاقة له بالمشاعر؟ تجربة بحثية حديثة أجراها باحثون من Google DeepMind وجامعة Stanford وجدت أن رمزًا بصريًا بسيطًا قد يغيّر الطريقة التي يختار بها نموذج الذكاء الاصطناعي حل المشكلة، حتى عندما لا يضيف الرمز أي معلومة برمجية واضحة.
الدراسة المنشورة على arXiv في 27 أكتوبر 2026 تحمل عنوان A Heart Means Recursion: Exploring Visual Meaning and Communication in VLMs. وهي لا تتحدث عن تحسّن جودة الكود بسبب القلب، بل عن تأثير الصور والرموز على سلوك نماذج الرؤية واللغة (VLMs)، وكيف يمكن لهذا التأثير أن يحدث دون أن تتمكن النماذج من تفسيره بدقة.
اختبار برمجي عادي.. وصورة قلب تغيّر الاختيار
استخدم الباحثون مسألة اجتياز شجرة ثنائية (Binary Tree Traversal)، وتحديدًا المرور الوسطي (Inorder Traversal). ويمكن حل هذه المسألة بطريقتين صحيحتين: التكرار الذاتي (Recursion)، حيث تستدعي الدالة نفسها لمعالجة الفروع، أو التكرار باستخدام الحلقات (Iteration)، مع الاحتفاظ بحالة التنفيذ يدويًا.
في الاختبار، أرفق الفريق صورة رمز بصري بسيط مع نص المسألة، وطلب من النموذج النظر إلى الصورة أثناء اختيار أسلوب الحل. ثم قارن الباحثون نسبة الإجابات التي استخدمت Recursion بخط أساس لم يتضمن صورة.
كانت النتيجة الأبرز أن صورة القلب الأحمر دفعت Claude Opus 4.7 وGPT-5.4 إلى استخدام Recursion في 100% من العينات، بينما لم يستخدما هذا الأسلوب في خط الأساس دون صورة. أما Gemini 3.1 Pro فكان أكثر استجابة لرمز مختلف؛ إذ رفع رسم علامة صح صفراء نسبة الحلول المعتمدة على Recursion إلى 90%، مقارنة بنحو 40% في خط الأساس.
هذه النسب لا تعني أن القلب جعل الإجابة أصح؛ فالطريقتان صحيحتان للمسألة. ما تغيّر هو تفضيل النموذج لطريقة كتابة الحل، وليس بالضرورة دقته أو كفاءته.
لماذا لم يكن الأمر مجرد فهم لمعنى القلب؟
لم يكتف الباحثون بتجربة القلب، بل اختبروا مكتبة تضم 288 رمزًا بصريًا ناتجة عن دمج 24 شكلًا مع 12 لونًا. كما استخدموا اختبارات مقارنة، منها استبدال الصورة بوصف نصي لها، أو بصورة ضوضاء عشوائية، أو بصور طبيعية.
اللافت أن الوصف النصي الذي يشرح الرمز، مثل «صورة لقلب وردي»، لم ينتج التأثير نفسه الذي أحدثته الصورة. كما كان تأثير الضوضاء والصور الطبيعية أقل بكثير. وهذا يشير إلى أن خصائص بصرية في شكل الرمز ولونه وطريقة عرضه قد تؤثر في اختيار النموذج، وليس مجرد فهمه لكلمة «قلب» أو معناها الشائع لدى البشر.
النماذج لم تفسّر دائمًا سبب اختيارها
درس الفريق أيضًا تفسيرات النماذج للرموز في سجلات التفكير التي أنتجتها. ووجد فجوة بين ما تقوله النماذج عن الصورة وبين السلوك الذي يظهر في مخرجاتها: فقد تتغير طريقة كتابة الكود رغم أن النموذج يصف الصورة بأنها غير مرتبطة بالمهمة، أو يذكر أن الصورة أثرت في قراره بينما لا يظهر تأثير فعلي في اختياره.
هذه النقطة مهمة لأن تفسير النموذج لسلوكه لا يطابق دائمًا العوامل التي أثرت فعليًا في النتيجة. لذلك لا ينبغي التعامل مع شرح النموذج لسبب اختياره باعتباره سجلًا كاملًا أو موثوقًا لكل المؤثرات التي شكلت الإجابة.
هل تستطيع النماذج التواصل مع بعضها بالصور؟
امتدت التجارب إلى سيناريوهات يحاول فيها نموذج إرسال صورة إلى نموذج آخر لنقل معنى أو توجيه اختياره. وظهرت مشكلة وصفها الباحثون بأنها فجوة بين التوليد والتفسير (Generation–Interpretation Gap): فالرموز التي يراها النموذج المرسل واضحة ومنطقية، وقد تبدو مفهومة للبشر أيضًا، لكنها لا تؤثر بالضرورة بالطريقة المقصودة في النموذج المستقبل.
وفي تجارب أخرى، استطاعت النماذج استخدام رسومات أكثر تعقيدًا لنقل مفاهيم وقصص، لكن بعض هذه الرسائل البصرية لم يكن بديهيًا للمراقبين البشر. وهذا يفتح مجالًا لدراسة لغة بصرية ناشئة بين النماذج، لكنها ليست لغة موحدة أو مضمونة الفهم بين الأنظمة المختلفة.
ما أهمية النتيجة لمطوري وكلاء الذكاء الاصطناعي؟
تزداد أهمية هذه النتائج مع انتشار الوكلاء الذين يتعاملون مع واجهات المواقع والتطبيقات عبر لقطات الشاشة والأيقونات والعناصر المرئية. فإذا كان الرمز الموجود في الصورة قادرًا على تغيير اختيار النموذج في تجربة مضبوطة، فمن المهم ألا يفترض المطور أن الصور مجرد معلومات محايدة أو أن تأثيرها يمكن استنتاجه دائمًا من تفسير النموذج النصي.
هذا لا يثبت وجود ثغرة أمنية أو إمكانية توجيه أي وكيل عبر وضع قلب أحمر أمامه. لكنه يلفت النظر إلى مصدر إضافي محتمل للتأثير على سلوك الأنظمة متعددة الوسائط، ويشجع على اختبار المدخلات البصرية المتنوعة، ومراقبة المخرجات، وعدم الاعتماد على تبرير النموذج وحده لفهم قراراته.
حدود الدراسة وما الذي لا تثبته
الدراسة متاحة بوصفها ورقة بحثية أولية (Preprint) على arXiv، وليست وحدها دليلًا على أن النتيجة ستتكرر في كل مهمة أو نموذج أو سياق عملي. كما أن تجربة البرمجة اعتمدت على مسألة محددة وعينات محدودة لكل إعداد، لذلك يجب التعامل مع النسب باعتبارها نتائج ذلك الاختبار، لا قاعدة عامة عن جميع نماذج الذكاء الاصطناعي.
الخلاصة أن صورة صغيرة قد تحمل للنموذج إشارة تؤثر في طريقة استجابته، حتى عندما لا يكون معناها الظاهر للبشر مرتبطًا بالمهمة. والدرس الأهم للمطورين ليس استخدام الرموز لتوجيه النماذج، بل إدراك أن المدخلات المرئية قد تؤثر في السلوك بطرق لا يشرحها النموذج نفسه دائمًا.
المصدر
- A Heart Means Recursion: Exploring Visual Meaning and Communication in VLMs – arXiv
- DAIR.AI Academy – ملخص الورقة ونتائج التجارب
اكتشاف المزيد من lightweb2
اشترك للحصول على أحدث التدوينات المرسلة إلى بريدك الإلكتروني.